大数据学习路线

怎么学大数据

大数据指不用随机分析法这样捷径,而采用所有数据进行分析处理的方法。互联网时代每个企业每天都要产生庞大的数据,对数据进行储存,对有效的数据进行挖掘分析并应用需要依赖于大数据开发,千锋大数据开发课程采用真实商业数据源并融合云计算+机器学习,让学员有实力入职一线互联网企业。

大数据培训课程 >
Linux&&Hadoop生态体系

  • Linux大纲
    1) Linux的介绍,Linux的安装:VMware Workstation虚拟软件安装过程、CentOS虚拟机安装过程 2) 了解机架服务器,采用真实机架服务器部署linux 3) Linux的常用命令:常用命令的介绍、常用命令的使用和练习 4) Linux系统进程管理基本原理及相关管理工具如ps、pkill、top、htop等的使用; 5) Linux启动流程,运行级别详解,chkconfig详解 6) VI、VIM编辑器:VI、VIM编辑器的介绍、VI、VIM扥使用和常用快捷键 7) Linux用户和组账户管理:用户的管理、组管理 8) Linux磁盘管理,lvm逻辑卷,nfs详解 9) Linux系统文件权限管理:文件权限介绍、文件权限的操作 10) Linux的RPM软件包管理:RPM包的介绍、RPM安装、卸载等操作 11) yum命令,yum源搭建 12) Linux网络:Linux网络的介绍、Linux网络的配置和维护 13) Shell编程:Shell的介绍、Shell脚本的编写 14) Linux上常见软件的安装:安装JDK、安装Tomcat、安装mysql,web项目部署
  • 大型网站高并发处理
    1) 第四层负载均衡 a) Lvs负载均衡 i. 负载算法,NAT模式,直接路由模式(DR),隧道模式(TUN) b) F5负载均衡器介绍 2) 第七层负载均衡 a) Nginx b) Apache 3) Tomcat、jvm优化提高并发量 4) 缓存优化 a) Java缓存框架 i. Oscache,ehcache b) 缓存数据库 i. Redis,Memcached 5) Lvs+nginx+tomcat+redis|memcache构建二层负载均衡千万并发处理 6) Haproxy 7) Fastdfs小文件独立存储管理 8) Redis缓存系统 a) Redis基本使用 b) Redis sentinel高可用 c) Redis好友推荐算法
  • Lucene课程
    1) Lucene介绍 2) Lucene 倒排索引原理 3) 建索引 IndexWriter 4) 搜索 IndexSearcher 5) Query 6) Sort和 过滤 (filter) 7) 索引优化和高亮
  • Solr课程
    1) 什么是solr 2) 为什么工程中要使用solr 3) Solr的原理 4) 如何在tomcat中运行solr 5) 如何利用solr进行索引与搜索 6) solr的各种查询 7) solr的Filter 8) solr的排序 9) solr的高亮 10) solr的某个域统计 11) solr的范围统计 12) solrcloud集群搭建
  • Hadoop离线计算大纲
    1) Hadoop生态环境介绍 2) Hadoop云计算中的位置和关系 3) 国内外Hadoop应用案例介绍 4) Hadoop 概念、版本、历史 5) Hadoop 核心组成介绍及hdfs、mapreduce 体系结构 6) Hadoop 的集群结构 7) Hadoop 伪分布的详细安装步骤 8) 通过命令行和浏览器观察hadoop 9) HDFS底层工作原理 10) HDFS datanode,namenode详解 11) Hdfs shell 12) Hdfs java api 13) Mapreduce四个阶段介绍 14) Writable 15) InputSplit和OutputSplit 16) Maptask 17) Shuffle:Sort,Partitioner,Group,Combiner 18) Reducer 19) 二次排序 20) 倒排序索引 21) 最优路径 22) 电信数据挖掘之-----移动轨迹预测分析(国内棱镜计划) 23) 社交好友推荐算法 24) 互联网精准广告推送 算法 25) 阿里巴巴天池大数据竞赛 《天猫推荐算法》案例 26) Mapreduce实战pagerank算法 27) Hadoop2.x集群结构体系介绍 28) Hadoop2.x集群搭建 29) NameNode的高可用性(HA) 30) HDFS Federation 31) ResourceManager 的高可用性(HA) 32) Hadoop集群常见问题和解决方法 33) Hadoop集群管理
  • 分布式数据库Hbase
    1) HBase与RDBMS的对比 2) 数据模型 3) 系统架构 4) HBase上的MapReduce 5) 表的设计 6) 集群的搭建过程讲解 7) 集群的监控 8) 集群的管理 9) HBase Shell以及演示 10) Hbase 树形表设计 11) Hbase 一对多 和 多对多 表设计 12) Hbase 微博 案例 13) Hbase 订单案例 14) Hbase表级优化 15) Hbase 写数据优化 16) Hbase 读数据优化
  • 数据仓库Hive
    1) 数据仓库基础知识 2) Hive定义 3) Hive体系结构简介 4) Hive集群 5) 客户端简介 6) HiveQL定义 7) HiveQL与SQL的比较 8) 数据类型 9) 外部表和分区表 10) ddl与CLI客户端演示 11) dml与CLI客户端演示 12) select与CLI客户端演示 13) Operators 和 functions与CLI客户端演示 14) Hive server2 与jdbc 15) 用户自定义函数(UDF 和 UDAF)的开发与演示 16) Hive 优化
  • 数据迁移工具Sqoop
    1) 介绍 和 配置Sqoop 2) Sqoop shell使用 3) Sqoop-import a) DBMS-hdfs b) DBMS-hive c) DBMS-hbase 4) Sqoop-export
  • Flume分布式日志框架
    1) flume简介-基础知识 2) flume安装与测试 3) flume部署方式 4) flume source相关配置及测试 5) flume sink相关配置及测试 6) flume selector 相关配置与案例分析 7) flume Sink Processors相关配置和案例分析 8) flume Interceptors相关配置和案例分析 9) flume AVRO Client开发 10) flume 和kafka 的整合
  • Zookeeper开发
    1) Zookeeper java api开发 2) Zookeeper rmi高可用分布式集群开发 3) Zookeeper redis高可用监控实现 4) Netty 异步io通信框架 5) Zookeeper实现netty分布式架构的高可用
  • 某一线公司的真实项目
    项目技术架构体系: a) Web项目和云计算项目的整合 b) Flume通过avro实时收集web项目中的日志 c) 数据的ETL d) Hive 批量 sql执行 e) Hive 自定义函数 f) Hive和hbase整合。 g) Hbase 数据支持 sql查询分析 h) Mapreduce数据挖掘 i) Hbase dao处理 j) Sqoop 在项目中的使用。 k) Mapreduce 定时调用和监控

大数据计算框架体系

  • Storm基础
    • Storm是什么
    • Storm架构分析
    • Storm编程模型、Tuple源码、并发度分析
    • Maven环境快速搭建
    • Storm WordCount案例及常用Api
    • Storm+Kafka+Redis业务指标计算
    • Storm集群安装部署
    • Storm源码下载编译

  • Storm原理
    • Storm集群启动及源码分析
    • Storm任务提交及源码分析
    • Storm数据发送流程分析
    • Strom通信机制分析浅谈
    • Storm消息容错机制及源码分析
    • Storm多stream项目分析
    • Storm Trident和传感器数据
    • 实时趋势分析
    • Storm DRPC(分布式远程调用)介绍
    • Storm DRPC实战讲解
    • 编写自己的流式任务执行框架

  • 消息队列kafka
    • 消息队列是什么
    • kafka核心组件
    • kafka集群部署实战及常用命令
    • kafka配置文件梳理
    • kafka JavaApi学习
    • kafka文件存储机制分析
    • kafka的分布与订阅
    • kafka使用zookeeper进行协调管理

  • Redis
    • nosql介绍
    • redis介绍
    • redis安装
    • 客户端连接
    • redis的数据功能
    • redis持久化
    • redis应用案例

  • zookeper
    • Zookeeper简介
    • Zookeeper集群部署
    • zookeeper核心工作机制
    • Zookeeper命令行操作
    • Zookeeper客户端API
    • Zookeeper应用案例
    • Zookeeper原理补充

  • 日志告警系统项目实战
    • 需求分析
    • 架构及功能设计
    • 数据采集功能开发及常见问题
    • 数据库模型设计及开发
    • Storm程序设计及功能开发
    • 集成测试及运行
    • 优化升级及常见问题

  • 猜你喜欢推荐系统实战
    • 推荐系统基础知识
    • 推荐系统开发流程分析
    • mahout协同过滤Api使用
    • Java推荐引擎开发实战
    • 推荐系统集成运行

云计算体系

  • Docker 课程
    • 基本介绍
    • vm docker 对比
    • docker基本架构介绍
    • unfs cgroup namespace
    • 进程虚拟化 轻量级虚拟化
    • docker 安装
    • docker 镜像制作
    • docker 常用命令
    • docker 镜像迁移
    • docker pipework(i.openvswitch)
    • docker weave
  • ReactJS框架
    • 虚拟化介绍,虚拟化适用场景等等
    • Qemu Libvirt & KVM
    • 安装KVM, Qemu, Libvirt
    • QEMU-KVM: 安装第一个能上网的虚拟机
    • Kvm虚拟机 nat,网桥基本原理
    • kvm虚拟机克隆
    • kvm虚拟机vnc配置
    • kvm虚拟机扩展磁盘空间
    • Kvm快照
    • Kvm 迁移
    • Java,python,c语言编程控制kvm
    • 构建自己的虚拟云平台
  • AngularJS框架
    • openstack介绍和模块基本原理分析
    • openstack多节点安装部署(a.采用centos6.x系统)
    • Keystone基本原理
    • glance
    • Cinder
    • Swift
    • Neutron
    • Openstack api 二次开发

机器学习&&深度学习

  • R语言&&机器学习
    1) R语言介绍,基本函数,数据类型 2) 线性回归 3) 朴素贝叶斯聚类 4) 决策树分类 5) k均值聚类 a) 离群点检测 6) 关联规则探索 7) 神经网络
  • Mahout机器学习
    1) 介绍为什么使用它,它的前景 a) 简单介绍Mahout b) 简单介绍机器学习 c) 实例演示Mahout单机推荐程序 2) 配置安装(hadoop2.x版本的)编译安装步骤说明 a) 命令行中测试运行协同过滤概念 3) 推荐 a) 讲解基于用户的协同过滤 b) 讲解基于物品的协同过滤 4) 分类 a) 分类概念 b) 分类的应用及Mahout分类优势 c) 分类和聚类、推荐的区别 d) 分类工作原理 e) 分类中概念术语 f) 分类项目工作流 g) 如何定义预测变量 h) 线性分类器的介绍,及贝叶斯分类器 i) 决策树分类器的介绍,及随机森林分类器 j) 如何使用贝叶斯分类器和随机森林分类器的代码展示 5) 聚类 a) 聚类概念 b) 聚类步骤流程 c) 聚类中的距离测度 d) 讲解K-means聚类 e) K-means聚类算法展示 f) 聚类其他算法 g) 介绍TF-IDF h) 归一化 i) 微博聚类案例
  • 项目实战
    项目技术架构体系: a) 分布式平台 Hadoop,MapReduce b) 数据采集 Flume c) 数据清洗 ETL d) 数据库 Hbase,Redis e) 机器学习 Mahout

实战项目

阿里核心项目+有价值商业数据
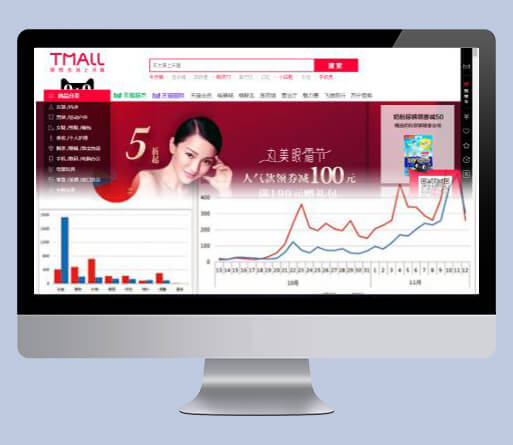
双11购物平台
项目难度:

技术要点 1、集群搭建 2、项目模块介绍 3、项目需求分析 4、项目技术方案设计 5、数据库表设计 6、项目搭建、JDBC组件开发 7、需求代码实现:Session聚合统计、top10热门商品、区域热门商
     统计、top10活跃用户、页面单跳转化率、广告点击流量实时统计
8、性能调优

亚信核心项目+有价值的商业数据
网站用户行为分析
项目难度:

技术要点 1、项目模块介绍 2、项目需求分析 3、项目技术方案设计 4、数据库表设计 5、数据预处理 6、数据存储 7、数据查询 8、可视化分析 9、分析消费者对商品的行为、商品购买热度Top10、每月购买商品量、消费者热点分布统计等。

Sina门户 + PB级数据量分析
新浪DSP系统用户行为分析
项目难度:

技术要点 1、人体识别 2、Python建模 3、提取并选择样本特征 4、特征工程 5、在训练本上训练模型 6、交叉验证 7、评估模型 8、检测率,精确率,F1 9、调整特征和模型 10、产品数据上线

千锋优势